
Un estudio internacional presentado en el Congreso ESMO 2026 presentó resultados especialmente prometedores para los cánceres de pulmón, esófago e hígado
La inteligencia artificial y modelos de aprendizaje automático basados en datos sanitarios demostraron su potencial para identificar a personas con mayor riesgo de desarrollar varios de los tipos de cáncer más frecuentes.
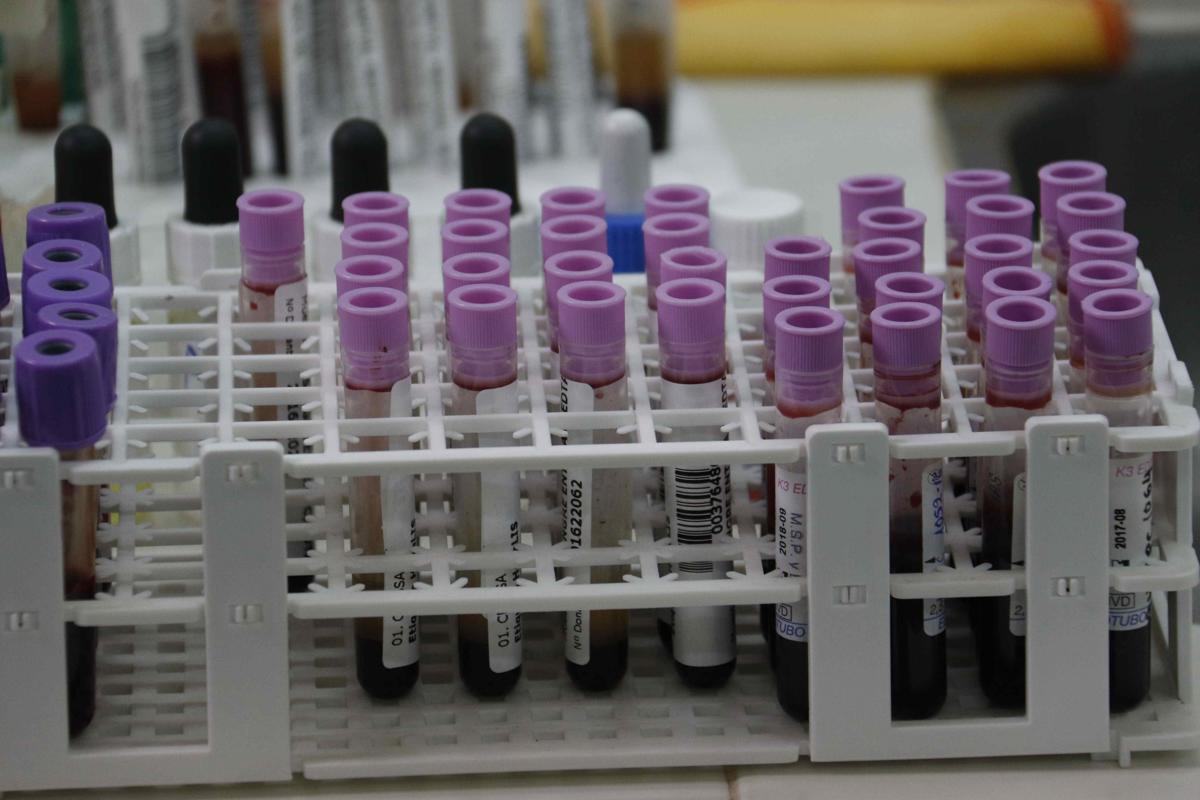
Así lo pone de relieve un estudio que se presentó en el congreso de la Sociedad Europea de Oncología Médica (ESMO), que se celebra en Madrid. Algunos de los datos que se recopilan de forma rutinaria, como los análisis de sangre, los antecedentes médicos y los factores relacionados con el estilo de vida, podrían ser muy útiles para detectar a las personas en riesgo.
Los investigadores desarrollaron alrededor de 500 modelos de aprendizaje automático para predecir el riesgo de desarrollar 20 tipos de cáncer frecuentes.
Para ello, utilizaron datos de 463.620 participantes del Biobanco del Reino Unido (UK Biobank), a quienes se realizó un seguimiento durante aproximadamente 18 años. Comprobaron que durante ese periodo, 57.055 participantes desarrollaron cáncer.
Los modelos se basaron en distintas variables, como los antecedentes médicos, los factores relacionados con el estilo de vida, los análisis de sangre y los datos genéticos y de los metabolitos.
Para evaluar la capacidad de los modelos, los investigadores los validaron con datos de participantes de Escocia y Gales. Incluyeron 42.036 personas del programa de investigación estadounidense All of Us y de más de tres millones de personas de una base de datos japonesa.
Además, para minimizar la posible influencia de enfermedades aún no diagnosticadas al inicio del estudio, se excluyeron del análisis correspondiente los casos de cáncer detectados durante el primer año de seguimiento. Los modelos superaron a los métodos estadísticos tradicionales, aunque su capacidad predictiva varió según el tipo de cáncer.
Para un resultado combinado que incluía los tipos de cáncer cuyo riesgo podía estimarse a partir de datos clínicos rutinarios, alcanzaron un área bajo la curva conocida como ‘ROC’ (AUROC) de 0,83 a 15 años. La métrica oscila entre 0,5, que indica una capacidad de discriminación equivalente al azar, y 1,0, que corresponde a una discriminación perfecta.
Resultados prometedores
Los resultados fueron especialmente prometedores para los cánceres de pulmón, esófago e hígado. Mientras, la capacidad predictiva fue más limitada para los de ovario, mama y cuello uterino.
En la leucemia mieloide aguda y el mieloma múltiple el rendimiento de los modelos disminuyó al ampliar el horizonte de predicción. Eso sugiere que algunas predicciones a corto plazo podrían estar detectando señales tempranas de tumores ya presentes, aunque todavía no se hubieran diagnosticado.
Gran parte de la capacidad predictiva de los modelos se basó en los resultados de análisis de sangre rutinarios y en los antecedentes clínicos.
Los análisis de sangre siguieron aportando información predictiva para los cánceres diagnosticados más de cinco años después, mientras que la incorporación de datos genéticos y los metabolómicos solo mejoró ligeramente el rendimiento de los modelos.
Además, el equipo desarrolló una herramienta (‘PRE-Screen), para que los agentes de IA basados en grandes modelos de lenguaje puedan ejecutar los modelos de predicción del riesgo de forma sistemática y coherente. Así, los ‘agentes’ que utilizaron esta herramienta obtuvieron resultados considerablemente mejores que aquellos que realizaron las predicciones sin este apoyo.
“En determinados tipos de cáncer, estos modelos podrían utilizarse como herramientas de precribado de bajo coste, basadas en datos que ya se recogen de forma habitual en la práctica clínica”, ha explicado el autor principal del estudio, el investigador Paul-Henry Koop, del Centro Else Kröner Fresenius de Salud Digital de la Universidad Técnica de Dresde (Alemania).
Los programas de cribado actuales se centran en determinados tipos de cáncer y suelen establecer criterios generales de elegibilidad, en lugar de evaluar el riesgo individual de cada persona, han señalado los investigadores.
En la Unión Europea, las recomendaciones de cribado se centraron tradicionalmente en los cánceres de mama, cuello uterino y colorrectal. Sin embargo, el Consejo de la UE también recomienda estudiar la posibilidad de ampliar estos programas a otros tipos de cáncer.
Los investigadores subrayaron la necesidad de realizar más estudios de validación para evaluar la fiabilidad de los modelos, su capacidad para generalizar los resultados a otras poblaciones y la posible presencia de sesgos.
Con información de EFE – Noti/Imágenes
Siguenos en:
Instagram: elpregon.news
Facebook: El Pregón Venezolano
“X” antes Twitter: @DiarioElPregón
Telegram: elpregon.news